LM: Difference between revisions
Jump to navigation
Jump to search
| Line 92: | Line 92: | ||
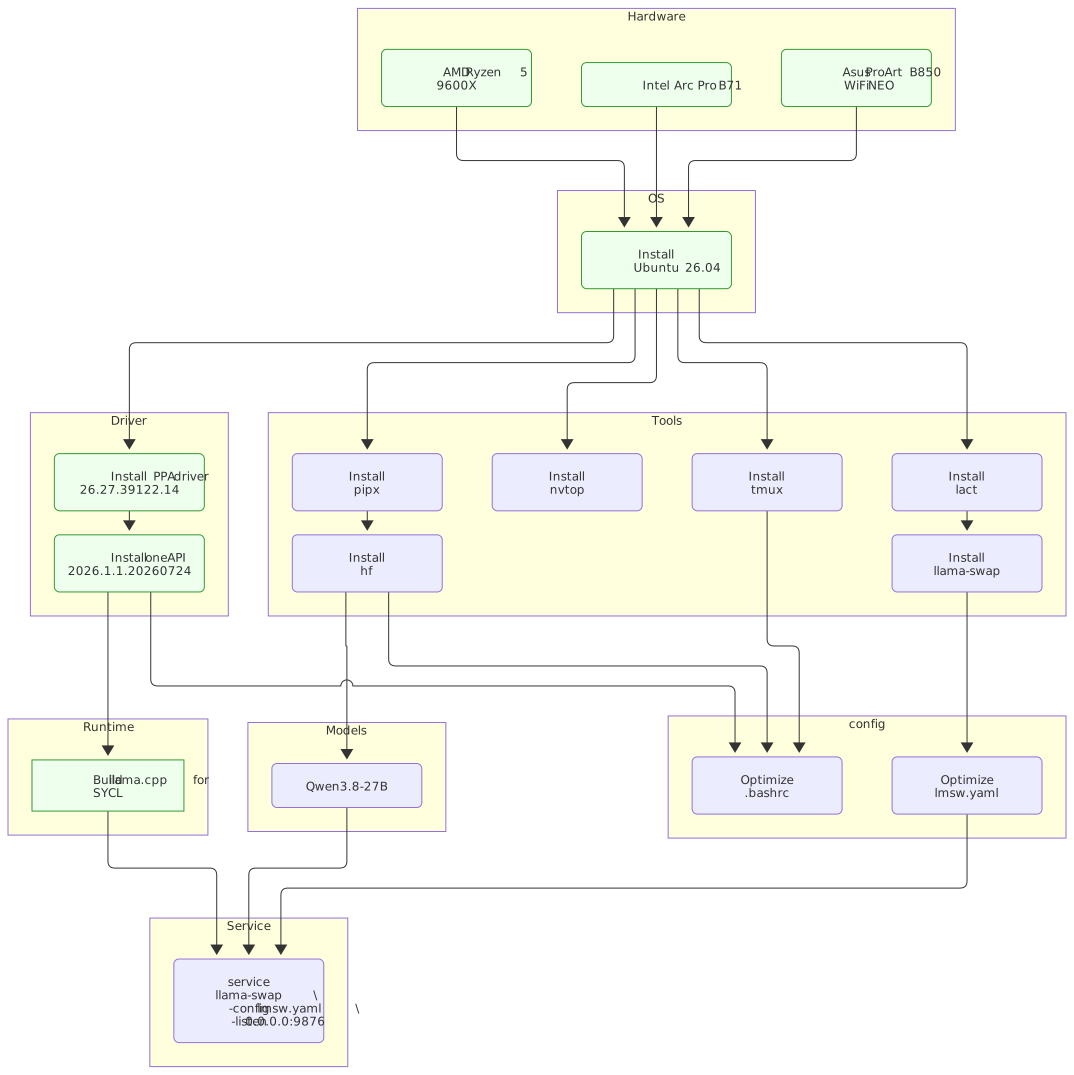
T3(Install<br>nvtop) | T3(Install<br>nvtop) | ||
T4(Install<br>tmux) | T4(Install<br>tmux) | ||
T5(Install<br>docker) | |||
T1 --> T2 | T1 --> T2 | ||
B1 --> T1 | B1 --> T1 | ||
B1 --> T3 | B1 --> T3 | ||
B1 --> T4 | B1 --> T4 | ||
B1 --> T5 | |||
end | end | ||
| Line 103: | Line 105: | ||
end | end | ||
subgraph | subgraph Config | ||
V1(Optimize<br>.bashrc) | V1(Optimize<br>.bashrc) | ||
V2(docker-compose.yaml) | |||
T2 --> V1 | T2 --> V1 | ||
T4 ----> V1 | T4 ----> V1 | ||
T5 --> V2 | |||
end | |||
subgraph Engine | |||
E1(Docker Image<br>vllm-openai-xpu<br>0.30.0+) | |||
C1 --> E1 | |||
T5 --> E1 | |||
M1 --> E1 | |||
V2 --> E1 | |||
end | end | ||
Revision as of 07:43, 22 October 2026
Topics
| 🤖 Agent | 🧠 Model | 🚀 Engine | ⚙️ GPU & Driver | 📊 Evaluation |
|---|---|---|---|---|
|
News
Models management
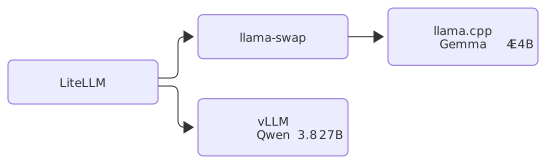
- llama-swap can launch model, cannot manage users.
- LiteLLM cannot launch model, can manage users.
Investigating vLLM on Intel Arc Pro B70
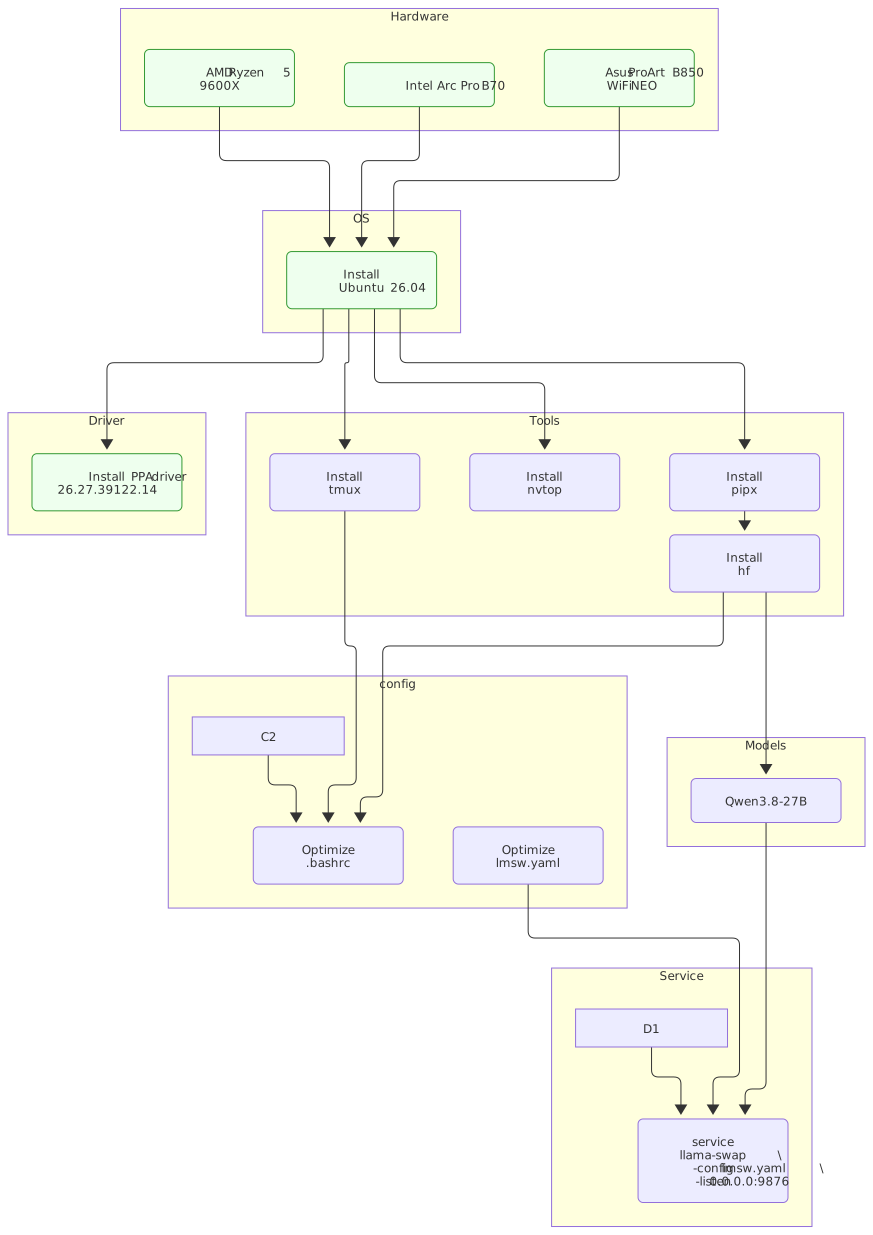
Investigating llama.cpp on Intel Arc Pro B70