LM: Difference between revisions
Jump to navigation
Jump to search
Tag: Reverted |
|||
| (24 intermediate revisions by the same user not shown) | |||
| Line 2: | Line 2: | ||
{| class="wikitable" | {| class="wikitable" | ||
! 🤖 | ! 🤖 Agent / Framework || 🧠 Model || 🚀 Engine || ⚙️ GPU & Driver || 📊 Evaluation | ||
|- | |- | ||
| style="width:200px;vertical-align:top" | | | style="width:200px;vertical-align:top" | | ||
: [[LM/ | : [[LM/Codex|Codex]] | ||
: [[LM/AnythingLLM|AnythingLLM]] | |||
: [[LM/jrswab_axe|axe]] | : [[LM/jrswab_axe|axe]] | ||
: [[LM/MCP|MCP]] | : [[LM/MCP|MCP]] | ||
: [[LM/Software Development|Software Development]] | |||
| style="width:200px;vertical-align:top" | | | style="width:200px;vertical-align:top" | | ||
: [[LM/hf|hf (Model Management)]] | : [[LM/hf|hf (Model Management)]] | ||
: [[LM/Qwen | : [[LM/Qwen 4 27B|Qwen 4 27B]] 🐣 | ||
: [[LM/Qwen 3.8 27B|Qwen 3.8 27B]] ⭐ | |||
: [[LM/Flint 40B|Flint 40B]] 🐣 | |||
: [[LM/Gemma 4|Gemma 4]] | |||
: [[LM/Bonsai 2 27B|Bonsai 2 27B]] | : [[LM/Bonsai 2 27B|Bonsai 2 27B]] | ||
: [[LM/ | : [[LM/Ornith 1.5 35B A3B|Ornith 1.5 35B A3B]] | ||
: [[LM/Experience|Experience]] | : [[LM/Experience|Experience]] | ||
| style="width:200px;vertical-align:top" | | | style="width:200px;vertical-align:top" | | ||
: [[LM/vLLM|vLLM]] | : [[LM/vLLM|vLLM]] ⭐ | ||
: [[LM/SGLang|SGLang]] 🐣 | |||
: [[LM/llama-swap|llama-swap]] | : [[LM/llama-swap|llama-swap]] | ||
: [[LM/ComfyUI|ComfyUI]] | : [[LM/ComfyUI|ComfyUI]] | ||
: [[LM/llama.cpp for SYCL|llama.cpp for SYCL]] | : [[LM/llama.cpp for SYCL|llama.cpp for SYCL]] | ||
: [[LM/llama.cpp for CUDA|llama.cpp for CUDA]] | : [[LM/llama.cpp for CUDA|llama.cpp for CUDA]] | ||
: [[LM/Inference Engine Comparison|Comparison]] | : [[LM/Inference Engine Comparison|Comparison]] | ||
| style="width:200px;vertical-align:top" | | | style="width:200px;vertical-align:top" | | ||
| Line 53: | Line 54: | ||
= Models management = | = Models management = | ||
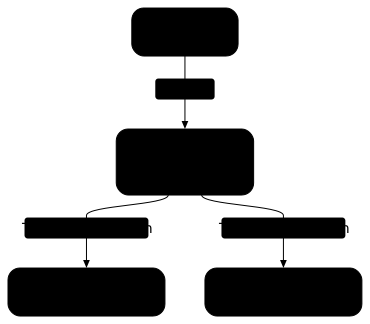
<quickmmd name="models-handling-infra"> | <quickmmd name="models-handling-infra" dump-env="true"> | ||
flowchart | flowchart TD | ||
A(LiteLLM) | A(LiteLLM 2) | ||
B(vLLM<br>Qwen 3.8 27B) | B(vLLM<br>Qwen 3.8 27B) | ||
C1(Intel Arc Pro B70) | C1(Intel Arc Pro B70) | ||
| Line 62: | Line 63: | ||
A --> |Forward| B | A --> |Forward| B | ||
B --> |Tensor Parallelism| C1 & C2 | B --> |Tensor Parallelism| C1 & C2 | ||
C1 --- |XCCL| C2 | %% C1 --- |XCCL| C2 | ||
</quickmmd> | </quickmmd> | ||
* llama-swap can launch model, cannot manage users. | * llama-swap can launch model, cannot manage users. | ||
* LiteLLM cannot launch model, can manage users. | * LiteLLM cannot launch model, can manage users. | ||
= Investigating vLLM on Intel Arc Pro B70 = | |||
<quickmmd name="tinkering-b70-vllm"> | |||
flowchart TD | |||
subgraph Hardware | |||
A1(Intel Arc Pro B70):::node-okay | |||
A2(Asus ProArt B850 WiFi NEO):::node-okay | |||
A3(AMD Ryzen 5 9600X):::node-okay | |||
end | |||
subgraph OS | |||
B1(Install<br>Ubuntu 26.04):::node-okay | |||
A1 & A2 & A3 --> B1 | |||
end | |||
subgraph Driver | |||
C1(Install PPA driver<br>26.27.39122.14):::node-okay | |||
B1 --> C1 | |||
end | |||
subgraph Tools | |||
T1(Install<br>pipx) | |||
T2(Install<br>hf) | |||
T3(Install<br>nvtop) | |||
T4(Install<br>tmux) | |||
T5(Install<br>docker) | |||
T1 --> T2 | |||
B1 --> T1 | |||
B1 --> T3 | |||
B1 --> T4 | |||
B1 --> T5 | |||
end | |||
subgraph Models | |||
M1(Qwen3.8-27B) | |||
T2 --> M1 | |||
end | |||
subgraph Config | |||
V1(Optimize<br>.bashrc) | |||
V2(docker-compose.yaml) | |||
T2 --> V1 | |||
T4 ----> V1 | |||
T5 --> V2 | |||
end | |||
subgraph Engine | |||
E1(Docker Image<br>vllm-openai-xpu<br>0.30.0+) | |||
C1 --> E1 | |||
T5 --> E1 | |||
M1 --> E1 | |||
V2 --> E1 | |||
end | |||
subgraph Service | |||
end | |||
classDef node-okay fill:#efe,stroke:#393 | |||
classDef node-warn fill:#fff0e0,stroke:#d63 | |||
classDef node-fail fill:#fee,stroke:#d33 | |||
classDef node-todo fill:#eee,stroke:#777 | |||
</quickmmd> | |||
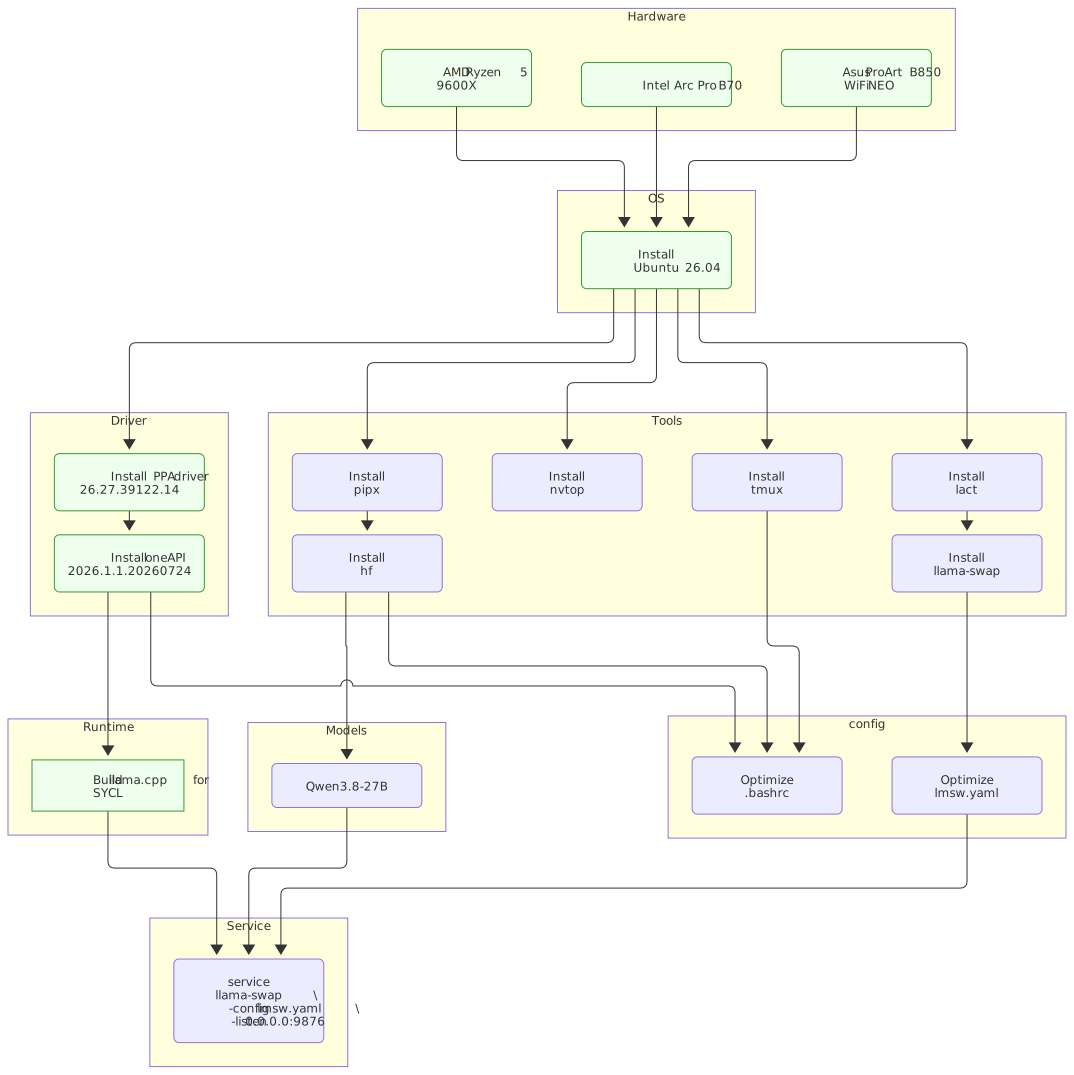
= Investigating llama.cpp on Intel Arc Pro B70 = | = Investigating llama.cpp on Intel Arc Pro B70 = | ||
| Line 73: | Line 137: | ||
flowchart TD | flowchart TD | ||
subgraph Hardware | subgraph Hardware | ||
A1(Intel Arc Pro | A1(Intel Arc Pro B70):::node-okay | ||
A2(Asus ProArt B850 WiFi NEO):::node-okay | A2(Asus ProArt B850 WiFi NEO):::node-okay | ||
A3(AMD Ryzen 5 9600X):::node-okay | A3(AMD Ryzen 5 9600X):::node-okay | ||
Latest revision as of 04:35, 11 November 2026
Topics
| 🤖 Agent / Framework | 🧠 Model | 🚀 Engine | ⚙️ GPU & Driver | 📊 Evaluation |
|---|---|---|---|---|
|
News
Models management
| File Path | /images/quickmmd/LM-models-handling-infra.svg |
|---|---|
| File Size | 3.07 KB |
| Last modified | 07:29:34 |
| Time of SVG loading | 0.00 second(s) |
| Time of SVG conversion | 0.19 second(s) |
| Cache Detected | Yes |
| SVG Engine | pele |
| Node Path | /usr/bin/node |
| Mermaid syntax Reference | https://mermaid.js.org/intro/syntax-reference.html |
| QuickMMD Version | 1.0.0 - About QuickMMD |
- llama-swap can launch model, cannot manage users.
- LiteLLM cannot launch model, can manage users.
Investigating vLLM on Intel Arc Pro B70

Investigating llama.cpp on Intel Arc Pro B70